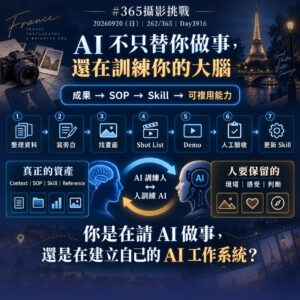
AI 最有價值的地方,不是替你多回答幾個問題,而是長期保存你的思考脈絡,讓經驗能被搜尋、比較、反省與再次使用。
從 12,159 則對話出發,這篇文章帶你建立一套不依賴意志力的個人記憶系統。
▋ Belief:你缺少的可能不是更聰明的 AI,而是連續的自己
當一份容量約 1GB、包含 12,159 則對話的 ChatGPT 備份被打開時,裡面不只是問題與答案。它記錄了一個人在超過一千個日子裡,如何學習、焦慮、做決定、照顧家人,並逐步把 AI 從搜尋工具變成工作系統。
多數人使用 AI 的方式是一次性的:今天問一個問題,拿到答案,關閉視窗;明天遇到類似困難,再從頭描述一次。這種用法確實方便,卻沒有形成長期複利。
真正的損失不是忘記某一個答案,而是失去「當時為什麼做這個決定」的脈絡。沒有脈絡,過去的成功無法複製,錯誤也容易重演。
模型能力決定一次回答的上限;記憶架構決定一個人能否累積十年的智慧。
日記的價值,不在於每天寫得精彩
在長期對話紀錄中,最有力量的未必是某個高明提示詞,而是「日記助手」幾乎每天出現。當紀錄從待辦事項變成生活狀態,意志力的重要性就會下降,系統的力量則開始上升。
一天的日記看起來很普通,一千天的日記卻能呈現模式:什麼情境讓你反覆拖延?哪些選擇後來證明正確?你在哪些時期最有創造力?哪些承諾總是被緊急事件打斷?
單篇內容可能沒有答案,但時間序列會說話。這也是個人資料與一般網路知識最大的差異:網路可以解釋世界,長期紀錄則能解釋你自己。
▋ Desire:我們真正想要的,是一個能理解人生脈絡的外腦
人們常把「第二大腦」理解成收藏更多文章、安裝更多筆記工具,或建立更複雜的分類系統。然而,沒有持續輸入與定期回顧,再精美的資料庫也只是數位倉庫。
真正有用的外腦應該能回答具體問題:我去年此時最擔心什麼?過去三次做出類似決策時,結果有何差異?哪一類工作最常消耗我的能量?某個專案最初的目的,是否已經在執行過程中偏移?
這些問題不只是生產力問題,也關係到生活品質。當重複整理、搜尋與行政工作交給系統,人才能把注意力留給家人、健康、教學、創造與真正重要的判斷。
從問答者到建構者的三階段進化
- 第一階段,使用者:把 AI 當成更自然的搜尋引擎,用來查詢旅遊、翻譯與一般知識。
- 第二階段,分析者:讓 AI 比較策略、整理資料、找出盲點,成為思考夥伴。
- 第三階段,建構者:要求 AI 協助建立自動化、知識庫、工作流與可重複執行的系統。
這三個階段並不是工具熟練度的排名,而是思維模式的改變。第一階段關心「這次答案是什麼」;第二階段關心「我應該如何判斷」;第三階段則追問「能不能把判斷方法留下來,讓下一次不必重新開始」。
真正的 AI 賦能,不只是把一件事做快,而是把做事的方法轉化成可重複的能力。
▋ Intention:用四層架構建立你的個人 AI 記憶系統
第一層:每天留下低摩擦原始紀錄
1,固定入口:選擇一個你每天一定會打開的入口,例如語音輸入、日記檔案或固定對話。不要要求自己同時維護五套筆記工具。
2,記錄決策脈絡:除了寫下做了什麼,也要留下為什麼做、當時有哪些限制、期待什麼結果。未來真正有價值的,往往就是這些背景。
3,允許不完美:原始紀錄不必像文章。口語、片段與情緒都可以保留,因為第一層的任務是捕捉,而不是出版。
第二層:把紀錄轉成可搜尋的結構
每則紀錄至少可以包含日期、主題、人物、專案與狀態。命名規則要穩定,日期格式要一致,重要決策應能連回原始內容。這些看似樸素的規則,會直接影響未來搜尋的準確度。
不要過度分類。分類太細會增加輸入成本,最後使人放棄紀錄。對大多數人來說,能依時間、主題與專案搜尋,已經足以支撐大量回顧需求。
如果使用向量搜尋或 AI 摘要,也要保留原始文字。摘要是解讀,不是原件;模型可能遺漏語氣、條件或例外,原始內容才是最後的查核依據。
第三層:建立每週回顧與模式辨識
每週選一個固定時段,請 AI 協助整理本週完成事項、未完成承諾、反覆出現的問題與值得保留的方法。接著由人確認:哪些是事實、哪些只是模型推論、哪些需要補證據。
你也可以固定詢問三個問題:本週哪個決定產生最大槓桿?哪個問題重複出現卻沒有被系統化?哪段經驗可以轉化成檢查表、教案、文章或工作流程?
這一步會把生活經驗從消耗品變成資產。一次教學可以留下教案,一次除錯可以留下故障手冊,一次客戶溝通可以留下需求訪談模板。你不再只是完成工作,也開始保存完成工作的方法。
第四層:只讓記憶服務於行動
收藏不是目的。每一項重要洞察都應該落到下一步,例如調整日程、停止低價值專案、更新作業流程,或安排一次需要人類判斷的對話。
如果系統只能告訴你「過去發生過什麼」,卻無法幫助你改善下一次選擇,它仍然只是一座檔案庫。好的個人 AI 應該把記憶轉換成提醒、選項與可執行步驟,但最終決策仍由人負責。
隱私與成本:外腦愈重要,治理愈不能省略
個人記憶可能包含健康、家庭、財務與工作機密。建立系統前,應先決定哪些資料可以送到雲端、哪些只能保留在本地、哪些內容需要去識別化,以及備份由誰保管。
本地化能提高控制權,但也會帶來儲存、備份、模型運算與維護成本;雲端服務比較方便,卻要承擔訂閱費、資料政策變動與平臺依賴。最務實的做法通常不是全面選邊,而是依敏感程度分層。
- 低敏感資料:可使用便利的雲端工具進行整理與搜尋。
- 中度敏感資料:先去識別化,再交由外部模型處理。
- 高度敏感資料:保留於本地或受控環境,並建立加密備份與存取權限。
不要因為追求最完整的記憶,就把所有資料無差別集中到單一平臺。真正成熟的第二大腦,不只記得更多,也知道哪些內容不該被看見。
今天就能開始的十五分鐘練習
打開你最常使用的筆記工具,寫下今天的一個重要決定。依序回答:「我看見了什麼?我想改善什麼?我決定採取哪一步?我要用什麼證據確認結果?」
七天後回頭檢查這項決定。不要只問自己有沒有做,而要確認結果是否真的改變。這就是最小版本的個人記憶閉環。
▋ AI 不應該讓你更像機器,而應該幫你取回人生主導權
長期紀錄的目的,不是把人生變成一堆指標,也不是讓模型替你決定未來。它的價值是讓你看見自己曾經相信什麼、追求什麼、採取什麼行動,以及結果如何。
技術可以被複製,工具也會快速更替;但你長期累積的決策脈絡、實作經驗與反思紀錄,會形成別人無法直接複製的數位護城河。
如果你已經累積大量對話、日記與工作文件,卻不知道如何整理成可搜尋、可回顧、可行動的個人 AI 系統,可以從盤點現有資料與風險開始。